Dropbox-API-Arg et les fichiers accentués, le premier bug de toute photothèque française
Le header Dropbox-API-Arg doit être de l'ASCII pur. Le premier « Vacances à Éze.jpg » casse le téléchargement. La règle d'échappement en une ligne.
L'intégration Dropbox marche parfaitement en dev. Premier utilisateur français, premier fichier « Vacances à Éze.jpg », première erreur 400.
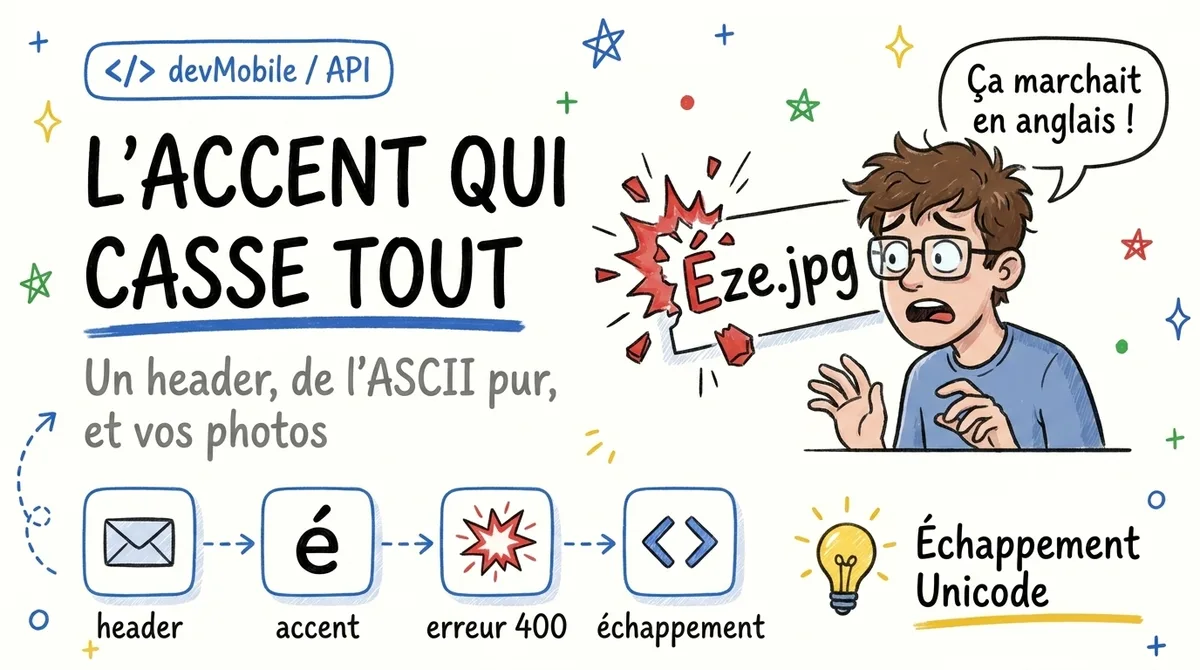
Micro-post, format gotcha : une règle précise, jamais mise en avant dans les tutoriels, garantie de casser sur toute photothèque française.
Le mécanisme
Les endpoints de contenu Dropbox (/files/download, /files/upload) ne prennent pas leurs paramètres dans le body : le body transporte le binaire. Les paramètres passent dans un header, Dropbox-API-Arg, sous forme de JSON.
Et un header HTTP, par spécification, c'est de l'ASCII. Le JSON, lui, autorise l'UTF-8 brut. Les deux mondes se rencontrent exactement ici :
POST /2/files/download
Dropbox-API-Arg: {"path": "/Photos/Vacances à Éze.jpg"}
Le à et le É sortent de l'ASCII : selon le client HTTP, la requête part corrompue ou est rejetée. Dropbox répond une erreur 400 sur le parsing du header, avec un message qui ne pointe pas vers l'encodage.
Le fix : une ligne
Le JSON supporte nativement l'échappement \uXXXX, qui produit de l'ASCII pur. Il suffit d'échapper tout caractère non-ASCII après la sérialisation :
String dropboxApiArg(Map<String, dynamic> args) =>
    jsonEncode(args).replaceAllMapped(
      RegExp(r'[^\x20-\x7E]'),
      (m) => '\\u${m[0]!.codeUnitAt(0).toRadixString(16).padLeft(4, '0')}',
    );
Avant / après :
{"path": "/Photos/Vacances à Éze.jpg"}
{"path": "/Photos/Vacances \u00e0 \u00c9ze.jpg"}
Même JSON, même signification, mais la deuxième forme traverse n'importe quel client HTTP. C'est d'ailleurs exactement ce que la doc Dropbox recommande, dans un paragraphe que personne ne lit parce que tout marche en anglais.
Pourquoi ce bug est un classique
Il passe tous les tests écrits par des développeurs qui nomment leurs fichiers test.jpg et photo_1.jpg. Il attend la prod, et les vrais utilisateurs : « Noël 2025 », « Randonnée forêt », « Bébé première année ». Sur une photothèque française, le taux de fichiers accentués n'est pas anecdotique, c'est la majorité.
Un test d'intégration avec un seul nom de fichier accentué aurait suffi. C'est le genre de cas que j'ajoute systématiquement aux suites de tests en audit : un fixture nommé à É è ü 漢字.jpg déclenche toute la famille de bugs d'encodage d'un coup.
À retenir
Dropbox-API-Arg= JSON dans un header HTTP = ASCII obligatoire.- Échappez tout non-ASCII en
\uXXXXaprèsjsonEncode: une regex d'une ligne. - Mettez au moins un nom de fichier accentué dans vos fixtures de test. Vos utilisateurs, eux, en ont des centaines.
Quel est le nom de fichier le plus exotique qui ait cassé une de vos intégrations ?